ローカルLLMを使い始めると、「結局どのモデルを選べばいい?」と迷うことがあります。
Qwen3、Gemma3、DeepSeek-R1など選択肢は多く、同じシリーズにも8Bや14Bなど複数のサイズがあります。
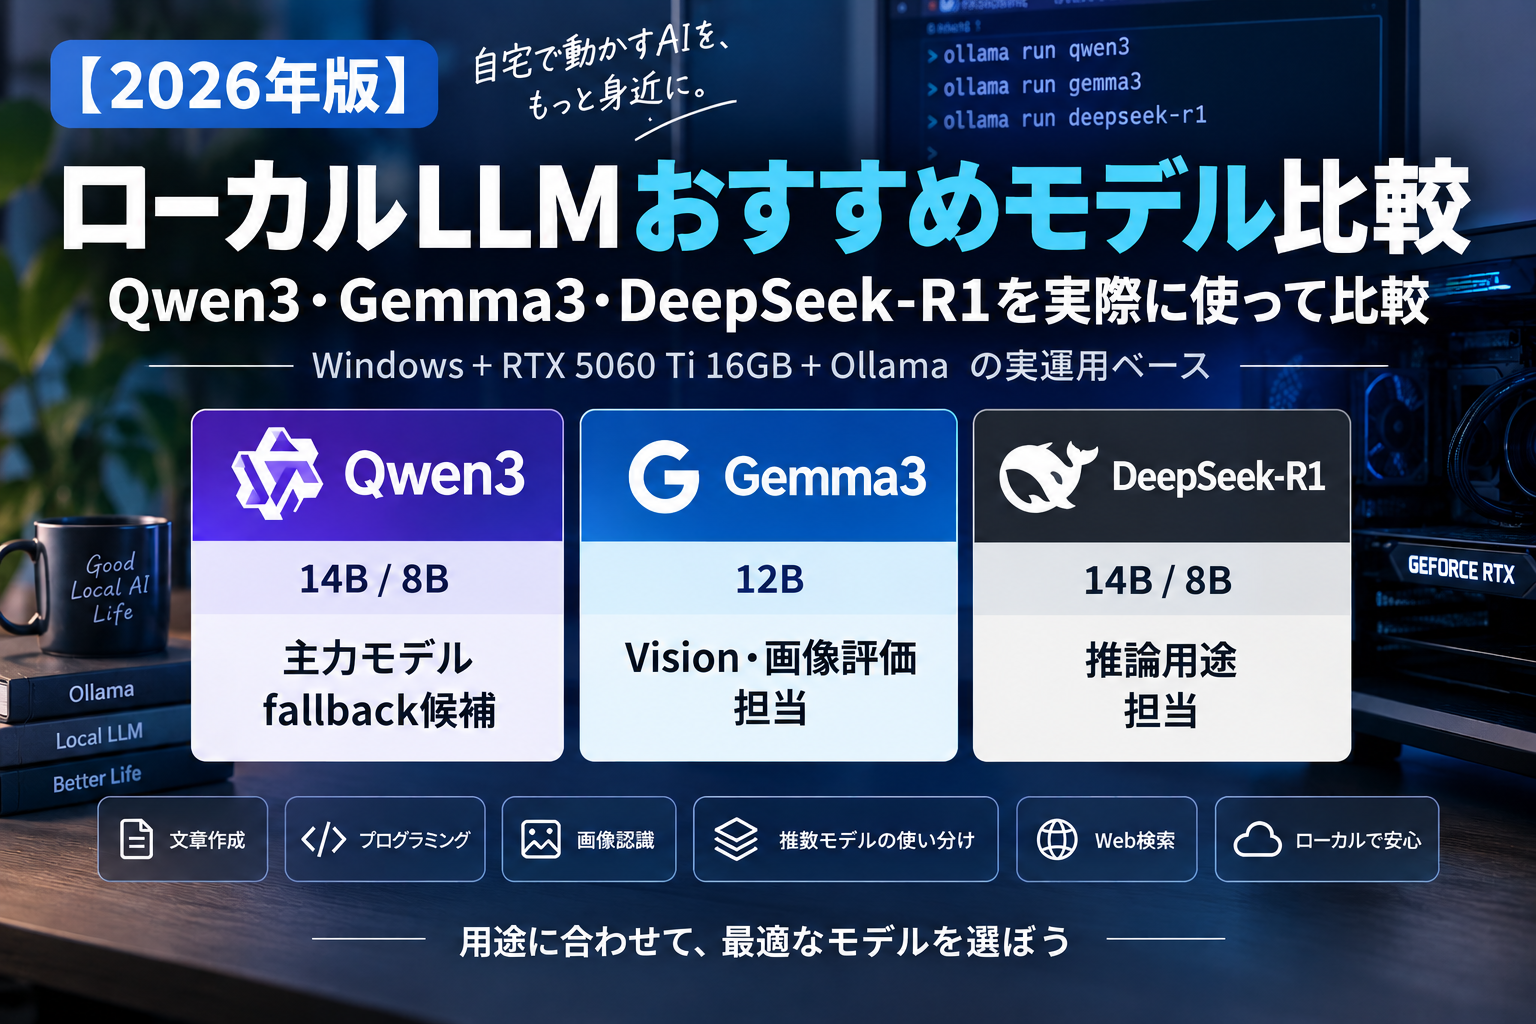
この記事では単純なベンチマーク比較ではなく、Melunicaで実際に使っているWindows+NVIDIA GeForce RTX 5060 Ti 16GB+Ollama環境をもとに、各モデルをどのように使い分けているかを紹介します。
今回取り上げるのはQwen3 14B・8B、Gemma3 12B、DeepSeek-R1 14B・8Bです。tokens/secや正確なVRAM使用量などのベンチマーク比較は行わず、実運用での役割と使い分けを中心に整理します。
まず結論:用途でモデルを使い分ける
| 用途 | モデル | Melunicaでの役割 |
|---|---|---|
| 普段のローカルAI処理 | Qwen3 14B | 主力モデル |
| fallback候補 | Qwen3 8B | 主力を補う候補 |
| Vision・画像評価 | Gemma3 12B | 画像を扱う処理 |
| 推論 | DeepSeek-R1 14B | 推論担当 |
| 軽量な推論用途 | DeepSeek-R1 8B | 推論用途の別候補 |
重要なのは、すべてを1つのモデルで処理する必要はないということです。MelunicaではQwen3 14Bを中心にしながら、画像を扱うときはGemma3 12B、推論用途ではDeepSeek-R1系へ切り替えています。
今回の実行環境
- OS:Windows
- GPU:NVIDIA GeForce RTX 5060 Ti 16GB
- ローカルLLM実行環境:Ollama
なお、Ollamaに表示されるモデルファイルサイズと、実行時のVRAM使用量は同じものではありません。実際の必要VRAMは量子化方式、コンテキスト長、KVキャッシュ、GPUへのオフロード量、利用ソフトウェアなどで変わります。
Qwen3 14B|現在の主力モデル
Melunicaで現在、主力として使っているのがQwen3 14Bです。
Qwen3はreasoning、instruction following、coding、agent capabilities、多言語対応などを備えたモデルファミリーで、thinking modeとnon-thinking modeを切り替えられる仕組みも用意されています。
MelunicaではDeveloper AIを含む普段のローカルAI処理をQwen3 14Bに担当させています。実際にRTX 5060 Ti 16GB環境で主力として使用しているため、「16GBなら8Bしか選べない」といった単純な選び方にはしていません。
ただし、これはMelunicaの現在の環境と運用についての話です。すべての16GB GPU環境で同じ条件になるという意味ではありません。
Qwen3 8B|fallback候補
Qwen3 8Bも導入していますが、現在はQwen3 14Bを主力としているため、Melunicaではfallback候補という位置付けです。
この記事では14Bと8Bの正確な生成速度やVRAM使用量を実測比較していないため、「8Bなら何GBで動く」「14Bより何倍速い」といった断定はしません。
複数サイズを用意しておけば、用途や環境に応じて切り替えられるという点を重視しています。
Gemma3 12B|Vision・画像評価担当
文章だけでなく画像を扱いたい場合に使っているのがGemma3 12Bです。
Gemma 3はテキストと画像を入力できるマルチモーダルモデルです。Melunicaではこの機能を利用し、Vision・画像評価担当として使っています。
つまり、普段の処理はQwen3、画像を見る必要がある処理はGemma3、という役割分担です。ローカルLLMは文章生成だけでなく、画像入力対応モデルを組み合わせることで用途を広げられます。
DeepSeek-R1 14B・8B|推論担当
推論用途として導入しているのがDeepSeek-R1系です。
Ollamaで使用している14BはDeepSeek-R1-Distill-Qwen-14B、8BはDeepSeek-R1-0528-Qwen3-8Bです。今回使っている14B・8Bは、フルサイズのDeepSeek-R1 671Bそのものではありません。
MelunicaではDeepSeek-R1 14Bを推論用途、DeepSeek-R1 8Bを軽量な推論用途として位置付けています。ここでも精度差や速度差は実測していないため断定しません。
RTX 5060 Ti 16GB環境ではどう使っている?
現在の中心はQwen3 14Bです。Developer AIなど普段のローカルAI処理ではQwen3 14Bを使い、画像を扱う必要があればGemma3 12B、推論用途ではDeepSeek-R1系へ切り替えます。
この運用で重要なのは、GPUのVRAM容量だけを見て使うモデルを1つに決めていないということです。
GPUやVRAM容量から環境を考えたい場合は、ローカルLLM用GPUの選び方も参考にしてください。
目的別にどのモデルから試す?
文章生成や普段使いを中心にしたい
MelunicaではQwen3 14Bを主力として使い、Qwen3 8Bをfallback候補として用意しています。
画像もローカルAIで扱いたい
Gemma3 12Bのようなマルチモーダルモデルが候補になります。MelunicaではVision・画像評価担当として利用しています。
推論用途を分けたい
DeepSeek-R1系を候補にできます。通常処理をQwen3に任せながら、推論用途を別モデルへ分ける運用です。
ローカルLLMは1モデルだけに決めなくていい
Ollamaでは複数モデルを用意し、処理内容によって切り替える運用ができます。
- Qwen3 14B:主力
- Qwen3 8B:fallback候補
- Gemma3 12B:Vision・画像評価
- DeepSeek-R1 14B:推論
- DeepSeek-R1 8B:軽量な推論用途として位置付け
「おすすめモデルを1つ選んで終わり」ではなく、用途ごとに役割を分けるのもローカルLLMの使い方のひとつです。
まとめ|おすすめは「用途に合ったモデル」
今回はWindows+RTX 5060 Ti 16GB+Ollamaという実環境をもとに、Qwen3・Gemma3・DeepSeek-R1の使い分けを紹介しました。
Melunicaでは、普段の処理はQwen3 14B、Qwen3 8Bはfallback候補、Vision・画像評価はGemma3 12B、推論はDeepSeek-R1 14B・8Bという役割分担にしています。
一番重要なのは「どのモデルが最強か」ではなく、何をさせたいかでモデルを選ぶという考え方です。
ローカルLLM自体が初めての場合は、ローカルLLMとは?自宅PCでAIを動かして分かったメリット・デメリットから読むと全体像をつかみやすくなります。
具体的な活用例を知りたい場合は、ローカルLLMで何ができる?実際の活用例とおすすめの使い方もあわせて参考にしてください。
※モデルの必要VRAM、生成速度、応答品質は、量子化方式、コンテキスト長、GPUへのオフロード量、実行ソフトウェア、設定などで変わります。本記事では未実測の性能差は断定していません。